
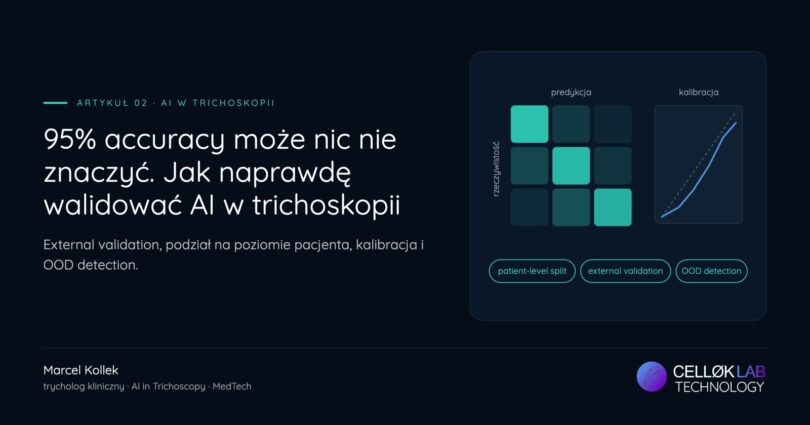

W materiałach o medycznej sztucznej inteligencji często pojawia się jedna liczba: 95%, 97%, czasem nawet 99% accuracy. Taki wynik brzmi jak dowód, że model jest prawie nieomylny. W rzeczywistości bez informacji o danych, sposobie podziału pacjentów i niezależnej walidacji może mówić bardzo niewiele o tym, jak system zachowa się w innym gabinecie.
Accuracy bez kontekstu jest słabą informacją
Wyobraźmy sobie dataset, w którym jedna klasa stanowi zdecydowaną większość przypadków. Model może osiągnąć wysoką accuracy, przewidując głównie tę klasę, a jednocześnie bardzo słabo wykrywać rzadsze choroby.
Dlatego w medycznym AI trzeba patrzeć szerzej: na sensitivity, specificity, precision, recall, F1, ROC-AUC, macierz pomyłek i wyniki dla poszczególnych klas. W zależności od zadania ważna jest też kalibracja, czyli zgodność deklarowanej pewności modelu z rzeczywistą częstością poprawnych odpowiedzi.
Najczęstszy błąd: leakage między pacjentami
W trichoskopii jeden pacjent może mieć wiele obrazów. Jeżeli część jego zdjęć trafi do treningu, a część do testu, model może uzyskać sztucznie zawyżony wynik. Może nauczyć się nie tylko cech choroby, ale również specyfiki konkretnej sesji, urządzenia, ustawień obrazu albo powtarzających się elementów charakterystycznych dla danego pacjenta.
Dlatego podział danych powinien następować na poziomie pacjenta. Jeden pacjent należy do jednego zbioru. To prosta zasada, ale fundamentalna dla wiarygodności badania.
External validation jest momentem prawdy
Model rozwijany w jednym ośrodku działa w kontrolowanym środowisku. Zdjęcia wykonują podobnie przeszkolone osoby, często tym samym sprzętem i według tego samego protokołu. Prawdziwy test zaczyna się wtedy, kiedy algorytm dostaje dane z innego miejsca.
Inna kamera, inne oświetlenie, inna populacja pacjentów, inni operatorzy i inne drobne artefakty mogą znacząco zmienić wyniki. External validation odpowiada więc na pytanie: czy model nauczył się klinicznego problemu, czy głównie lokalnego środowiska danych?
Model musi wiedzieć, kiedy nie wie
System medyczny nie powinien być zmuszony do odpowiedzi w każdej sytuacji. Jeżeli obraz jest złej jakości albo pochodzi z zupełnie innej dystrybucji niż dane treningowe, rozsądnym wynikiem może być „brak wiarygodnej klasyfikacji”. Tutaj pojawia się out-of-distribution detection i mechanizmy abstention.
Zamiast zawsze zwracać najwyższą z pięciu wartości, model może sygnalizować, że przykład jest nietypowy albo poziom pewności jest zbyt niski. W praktyce bezpieczny system nie musi mieć odpowiedzi na wszystko. Musi umieć rozpoznać granice własnego zastosowania.
Ground truth jest równie ważny jak architektura
AI uczy się na etykietach. Jeżeli etykiety są słabe, model nauczy się odtwarzać słabe etykiety. W trychologii nie każda diagnoza może być wiarygodnie ustalona tylko na podstawie zdjęcia. Część przypadków wymaga pełnego wywiadu, badania klinicznego, a wybrane jednostki także konsultacji lekarskiej lub histopatologii.
Marcel Kollek | AI in Trichoscopy | MedTech
Dlatego dataset powinien posiadać jasno zdefiniowany reference standard. Warto rozróżniać przypadki jednoznaczne, przypadki ocenione przez kilku ekspertów i przypadki, w których potwierdzenie wymagało dodatkowych danych klinicznych.
Prospective silent mode przed wdrożeniem
Bardzo wartościowym etapem jest testowanie modelu prospektywnie, ale bez wpływu na decyzje kliniczne. System analizuje bieżące przypadki, jednak jego wynik nie jest używany do prowadzenia pacjenta.
Takie podejście pozwala sprawdzić realne zachowanie algorytmu w codziennym przepływie pracy: ile obrazów odrzuca, jak radzi sobie z różnymi urządzeniami, gdzie pojawiają się błędy i czy rozkład danych różni się od zbioru rozwojowego. Dopiero później można przechodzić do badań wpływu systemu na rzeczywistą pracę specjalisty.
Wiarygodność jest ważniejsza niż rekordowa liczba
Dojrzały system AI nie powinien być oceniany na podstawie jednej atrakcyjnej liczby. Ważniejsze jest to, czy wynik da się odtworzyć, czy model działa poza miejscem, w którym powstał, czy potrafi sygnalizować niepewność i czy znane są jego ograniczenia.
W trichoskopii potrzebujemy mniej marketingu wokół „99% accuracy”, a więcej external validation, jawnej metodologii i wieloośrodkowych danych. Dopiero wtedy możemy mówić o technologii, która ma szansę działać nie tylko w prezentacji, ale również w realnym gabinecie.
O autorze
Marcel Kollek – trycholog kliniczny i twórca CELLØKLAB Technology. Zajmuje się zastosowaniem sztucznej inteligencji, computer vision i analizy danych w trichoskopii, ze szczególnym uwzględnieniem quantitative hair phenotyping, longitudinal monitoring oraz walidacji modeli AI.ORCID: 0009-0006-3190-5023
Publikacje: 10.5281/zenodo.22860797 oraz 10.5281/zenodo.22861453


